Pesquisadores AKCIT criam corpus de FakeNews de 51mil textos
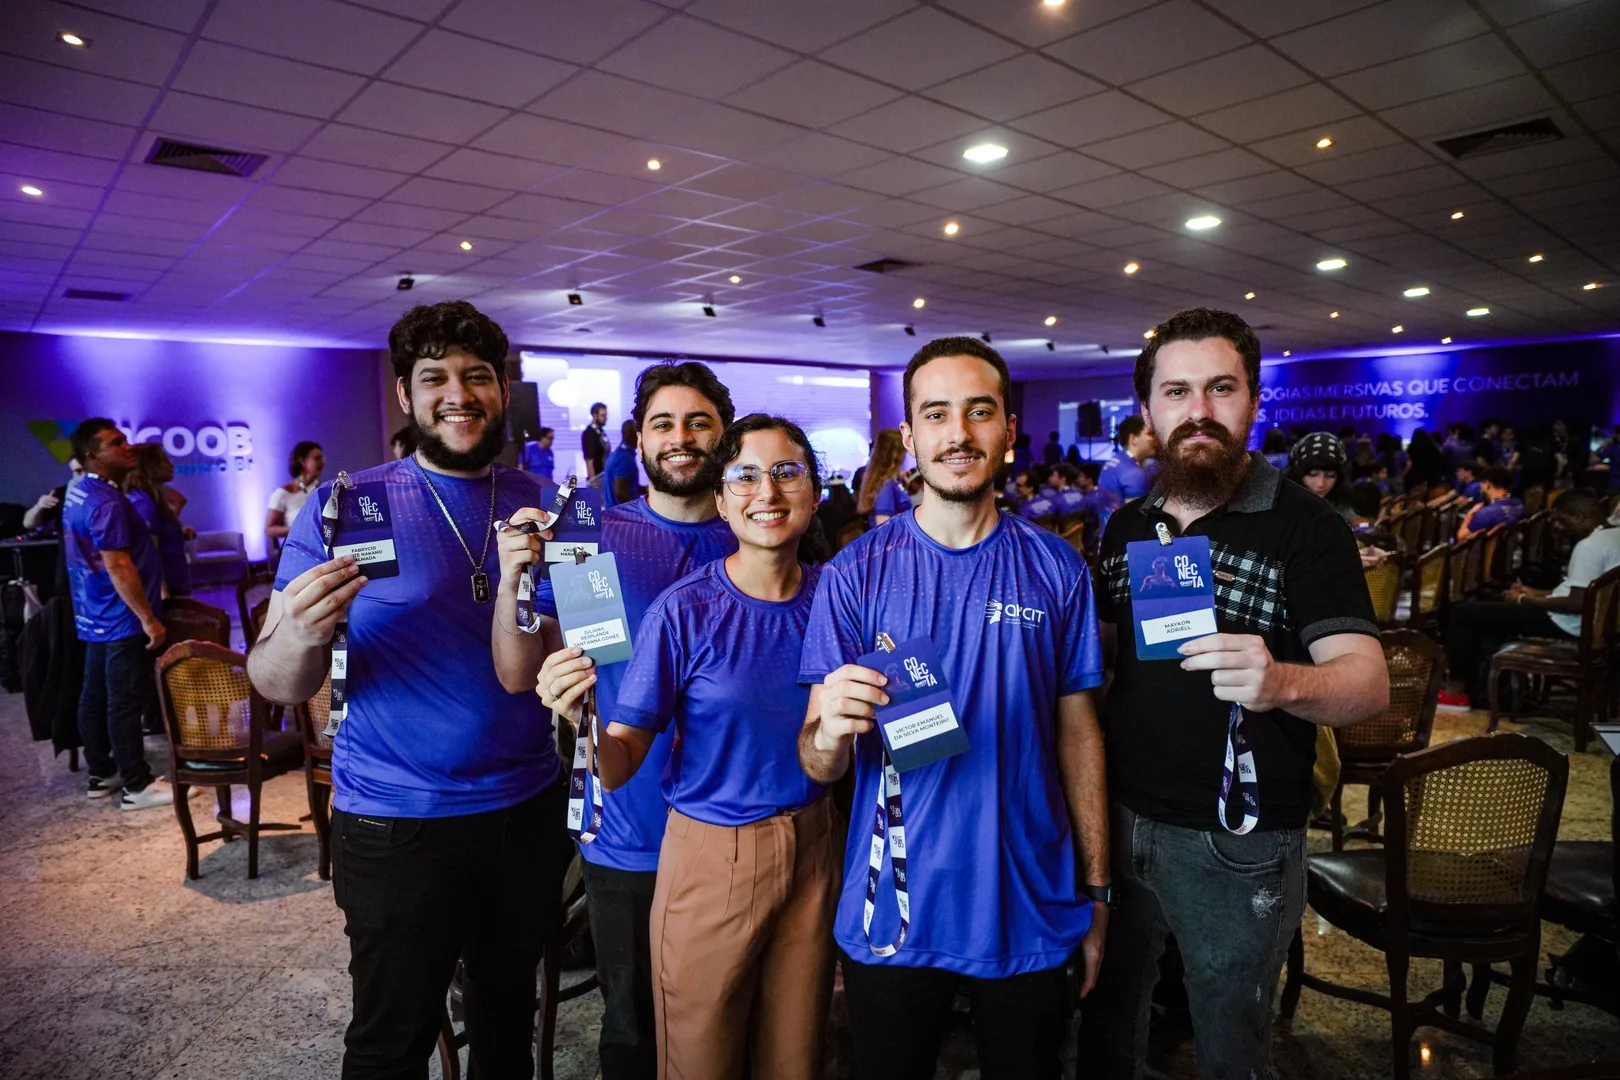
Desenvolvido por pesquisadores brasileiros, o FakenewsBR reúne conteúdos de diferentes fontes em uma estrutura unificada e busca facilitar o desenvolvimento de pesquisas sobre desinformação e inteligência artificial em língua portuguesa.
A disseminação de notícias falsas se tornou um dos grandes desafios da sociedade digital. Em um cenário no qual informações circulam rapidamente por redes sociais, aplicativos de mensagens e plataformas de comunicação, distinguir conteúdos confiáveis de informações enganosas exige cada vez mais conhecimento e pesquisa.
Mas, para desenvolver sistemas capazes de estudar e identificar a desinformação, existe um desafio que muitas vezes passa despercebido, a disponibilidade de dados organizados e preparados para pesquisas.
Foi diante desse problema que um grupo de pesquisadores ligados ao Centro de Competência EMBRAPII em Tecnologias Imersivas (AKCIT) e ao Centro de Excelência em Inteligência Artificial (CEIA), no ecossistema de pesquisa da Universidade Federal de Goiás (UFG), desenvolveu o FakenewsBR, um corpus integrado que reúne 51.205 registros textuais em língua portuguesa, provenientes de seis conjuntos de dados anteriormente publicados.
A iniciativa busca fortalecer pesquisas sobre desinformação no contexto brasileiro e oferecer recursos para o desenvolvimento e a avaliação de novas abordagens em inteligência artificial.
Processo de criação do FakenewsBR
Embora o combate às fake news seja frequentemente associado à criação de ferramentas capazes de identificar conteúdos falsos, o desenvolvimento dessas tecnologias começa muito antes, na coleta, preparação e organização das informações utilizadas pelos pesquisadores.
Atualmente, existem diferentes bases de dados sobre desinformação, construídas por instituições e grupos de pesquisa. Entretanto, esses conjuntos podem apresentar estruturas distintas, classificações diferentes e informações distribuídas de maneiras incompatíveis.
Na prática, isso significa que pesquisadores interessados em utilizar essas bases precisam dedicar parte considerável do trabalho à preparação e à integração dos dados, antes mesmo de iniciar seus experimentos.
O FakenewsBR foi desenvolvido para enfrentar esse desafio.
O projeto reúne diferentes conjuntos de dados sobre notícias e conteúdos digitais, organizando as informações em uma estrutura padronizada. O resultado é uma coleção que permite consultar e analisar registros provenientes de diferentes fontes de maneira mais consistente.
Em termos técnicos, essa coleção recebe o nome de corpus, um conjunto estruturado de textos utilizado em pesquisas computacionais, especialmente nas áreas de inteligência artificial e processamento de linguagem natural.
No caso do FakenewsBR, os registros incluem notícias, publicações de redes sociais, mensagens e outros conteúdos relacionados à circulação de informações no ambiente digital brasileiro.
O conjunto abrange registros datados de 2005 a 2022 e preserva informações que permitem identificar suas bases de origem, uma característica importante para compreender as diferenças entre os conteúdos analisados.
Mais de 51 mil registros organizados para novas pesquisas. A principal contribuição do projeto não está simplesmente na quantidade de informações reunidas, mas na maneira como esses dados foram integrados, tratados e disponibilizados.
Para construir o corpus, os pesquisadores desenvolveram um processo computacional que combina diferentes etapas de preparação dos dados, incluindo padronização de campos, limpeza de textos e identificação de conteúdos muito semelhantes.
Esse último procedimento é particularmente importante porque uma mesma informação pode aparecer em diferentes bases, ainda que apresentada com pequenas alterações. A análise de similaridade auxilia na identificação dessas ocorrências e permite sinalizar registros que precisam de uma avaliação mais cuidadosa.
O FakenewsBR também mantém classificações de veracidade provenientes dos conjuntos de dados originais, além de incorporar informações complementares de serviços de checagem de fatos quando disponíveis.
Dessa forma, a iniciativa oferece não apenas uma coleção de textos, mas também um conjunto de informações estruturadas que pode apoiar experimentos e análises desenvolvidos por outros pesquisadores.
Pesquisa brasileira apresentada em evento científico
O desenvolvimento do FakenewsBR resultou no artigo científico “FakenewsBR: A Unified Portuguese Misinformation Corpus for Reproducible Data Integration Research”, apresentado no contexto do Simpósio Brasileiro de Bancos de Dados (SBBD 2026), por meio do Dataset Showcase Workshop.
A pesquisa contou com o trabalho dos pesquisadores Kauan Divino Pouso Mariano, Fabrycio Leite Nakano Almada, Maykon Adriell Dutra e Victor Emanuel da Silva Monteiro, com orientação de Juliana Resplande e contribuições acadêmicas dos professores Anderson Soares e Arlindo Galvão.
A iniciativa foi desenvolvida no contexto das atividades de pesquisa relacionadas à inteligência artificial e ao estudo da desinformação, com apoio do AKCIT e do CEIA.
A apresentação científica representa uma oportunidade de compartilhar os resultados com a comunidade acadêmica, permitindo que outros pesquisadores conheçam a metodologia utilizada e explorem as possibilidades de aplicação do corpus.
Mais do que apresentar um recurso tecnológico, o projeto também evidencia a participação de pesquisadores brasileiros na construção de conhecimento voltado a desafios relevantes da sociedade contemporânea.
Como o FakenewsBR pode contribuir para o avanço da inteligência artificial?
A inteligência artificial depende de dados para aprender padrões, realizar classificações e ser avaliada em diferentes situações. Por isso, a qualidade e a organização das informações utilizadas são aspectos fundamentais para o desenvolvimento dessas tecnologias.
No campo da desinformação, conjuntos de dados como o FakenewsBR podem auxiliar na criação e na avaliação de modelos capazes de analisar textos e identificar características associadas a conteúdos classificados como falsos ou verdadeiros.
O corpus também abre possibilidades para investigações sobre as diferenças entre notícias e mensagens de redes sociais, padrões linguísticos presentes na desinformação e limitações de sistemas automatizados de classificação.
Outro aspecto relevante é o foco na língua portuguesa e no contexto brasileiro. A disponibilização de recursos específicos para esse cenário permite ampliar estudos considerando características da linguagem e dos ambientes digitais locais.
Além da integração das informações, um dos princípios centrais do FakenewsBR é a reprodutibilidade científica. Na prática, isso significa disponibilizar não apenas o resultado da pesquisa, mas também os procedimentos e as ferramentas utilizados na construção do corpus, permitindo que outras equipes compreendam e reproduzam suas etapas de processamento.
Os dados e o código do projeto foram disponibilizados publicamente, favorecendo a colaboração acadêmica e a continuidade de investigações nessa área
Saiba mais sobre o projeto
Artigo científico: "FakenewsBR: A Unified Portuguese Misinformation Corpus for Reproducible Data Integration Research" (https://sol.sbc.org.br/index.php/dsw/article/view/44058)
Código e ferramentas: "Repositório FakenewsBR no GitHub" (https://github.com/AKCIT-FN/fakenews-data)
Base de dados: "FakenewsBR no Hugging Face" (https://huggingface.co/datasets/kauandivino/FakenewsBR)
Sobre o autor
2 matérias publicadas
Bacharel em Inteligência Artificial pela Universidade Federal de Goiás (UFG), especialista em Inteligência Artificial Aplicada, mestrando em Ciência da Computação e pela UFG. Atua como pesquisador no Centro de Excelência em Inteligência Artificial (CEIA/UFG) e no AKCIT, desenvolvendo projetos que integram inteligência artificial, ciência de dados e inovação tecnológica. Possui experiência em pesquisa científica, desenvolvimento de soluções baseadas em IA, empreendedorismo com foco na aplicação da tecnologia para solucionar desafios reais da sociedade.
Mais matérias de Kauan Divino Pouso Mariano
Discussão
0 comentários
Notícias Relacionadas
IA e o Futuro das Escolhas do Consumidor
Discussão sobre IA foca na concentração de informações e mercado, impactando pequenas empresas.
 Erlon Cimardi•21/10/26
Oktobercloud 2026 conecta tecnologia e negócios em Blumenau
 EmpreendaNews•13/10/26
Apple quer transformar a casa inteligente com IA?
Apple amplia aposta em casas inteligentes com HomePod mini 2, nova Apple TV 4K e HomeView. Entenda como a inteligência artificial pode transformar a automação residencial.
 Carlos E. Backes•13/10/26